English · Norsk bokmål · Polski · 日本語 · 简体中文 · Español
🎧 试听语音示例
# Hangry Labs Faster Qwen3-TTS Studio
在本地使用 Qwen3-TTS 进行声音设计、声音克隆与语音生成。Studio 通过 Docker 打包,提供浏览器界面、流式播放和 HTTP API。
最新版本、更新历史及发布状态请查看[英文主文档](README.md)。
## 快速开始
安装好 Docker、NVIDIA GPU 支持及兼容 CUDA 12.8 的驱动后,只需运行一条命令:
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0@sha256:a8a3643b077e05c2ccf33e9b97978f082d2e89ac33b3d1368ab0e25df628899d
```
打开 **[http://localhost:7860](http://localhost:7860)**,即可开始生成语音。完整镜像包含五个固定版本的模型,拉取后可离线运行。模型、已保存的声音和脚本会保留在持久卷中。
更小的下载:tiny 镜像
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0_tiny@sha256:29f06b3226da4a55244727e111e7700786e53049a54560efeef4bb12a62bd0bd
```
Tiny 会在首次使用时将模型下载到同一持久卷。请保持联网,直至所选模型缓存完成。选择 full 或 tiny 其中一种即可。
无需 Git、宿主机 Python 或手动配置模型。开发请参阅[从源码构建](docs/DEVELOPMENT.md#build-from-source);更多信息见 [API 视图](http://localhost:7860/docs)及 [Docker Hub 指南](docs/dockerhub.md)。
## 功能
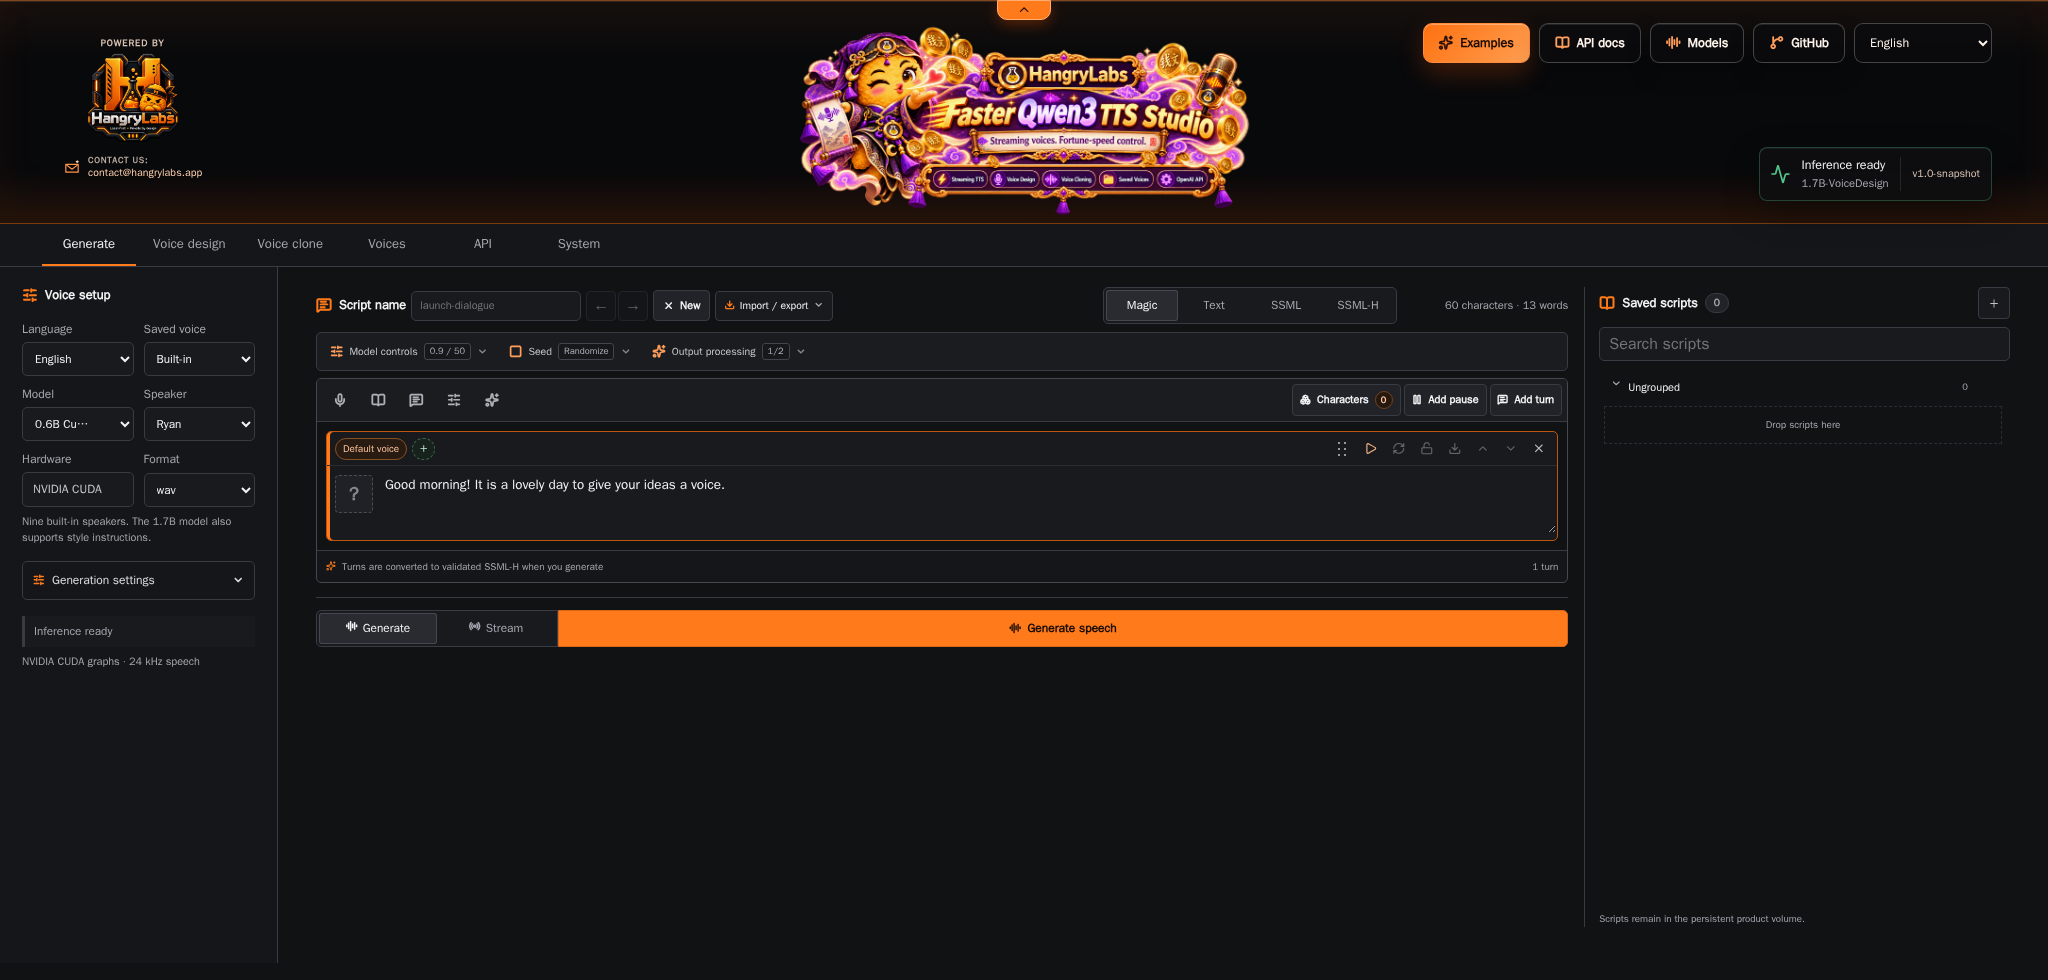
- 使用 1.7B VoiceDesign,根据自然语言描述设计新声音。
- 使用 0.6B 或 1.7B Base 克隆已获授权的参考录音,可添加实验性的表达指令。
- 使用 CustomVoice 的九种内置声音;内置声音的风格指令需要 1.7B 模型。
- 支持文本、SSML、SSML-H 和 Magic 可视化对话编辑,可管理角色、逐句片段和可复用录音。
- 声音库支持头像、标签、原始与处理后参考、创建设置恢复及声音调整。
- 上传或录制音频、波形裁剪、FFmpeg 音效和下载。
- OpenAI 兼容语音 API、原生 API,以及可选的精简与高级 MCP。
- FIFO 队列、取消生成、耗时诊断,以及 System 中的模型与 GPU 显存控制。
界面支持英语、挪威语书面语、波兰语、日语、简体中文和西班牙语。切换语言会保留未保存的文本、参考录音与生成音频;偏好保存在浏览器中。可直接访问 [/zh](http://localhost:7860/zh)。
**界面语言与合成语言相互独立。** Qwen 支持中文、英语、日语、韩语、德语、法语、俄语、葡萄牙语、西班牙语、意大利语及自动语言选择。挪威语和波兰语仅为界面语言,并非受支持的合成语言。示例文本跟随所选合成语言;Auto 使用英文示例。
## 模型与显存
| 模型系列 | 大小 | 用途 |
| --- | --- | --- |
| Base | 0.6B、1.7B | 根据参考音频克隆声音 |
| CustomVoice | 0.6B、1.7B | 九种内置声音 |
| VoiceDesign | 1.7B | 根据描述创建新声音 |
默认设置会将 0.6B Base、0.6B CustomVoice 和 1.7B VoiceDesign 保留在 GPU 显存中。可在 System 中为各工作流选择默认模型与常驻策略,或关闭权重保留。推理通过共享队列串行执行。目标硬件为 NVIDIA GPU,运行环境采用 Torch、Python 3.13 和 CUDA 12.8。
克隆时建议提供参考录音的准确文本。Base 的表达指令为实验功能,在仅说话人特征模式下可能被忽略。可选 ASR 需要配置外部服务,不会启动本地 ASR 模型。
## API
```bash
curl http://localhost:7860/v1/audio/speech -H "Content-Type: application/json" -d '{"model":"qwen3-tts","input":"Hello from Qwen Studio.","voice":"Ryan","response_format":"mp3"}' --output speech.mp3
```
语音 API 支持 MP3、WAV、FLAC、Opus、AAC、Ogg 和 PCM。浏览器流式播放使用 MP3。更多信息见 [API 指南](docs/API.md)、[SSML-H](docs/SSML-H.md)、[MCP](docs/MCP.md)和 [Studio 指南](docs/STUDIO.md)。技术指南以英文维护。
## 隐私与负责任使用
仅克隆已获本人同意的声音,不要使用合成语音进行欺骗性冒充。参考音频和脚本仅在明确保存时持久化;MCP 音频链接具有时效。执行转写时,录音会发送至你选择的外部 ASR,请配置可信服务。保留 localhost 端口绑定;如需向网络开放,请使用身份验证和适当的代理保护服务。
## 测试结果、上游与许可
[基准测试](benchmarks/README.md)提供实测速度、VRAM 占用及流式延迟。结果不保证适用于所有 GPU 或声音。
我们基于 [Qwen3-TTS](https://github.com/QwenLM/Qwen3-TTS)、[qwen-tts-hf 兼容分支](https://github.com/andimarafioti/Qwen3-TTS/tree/distribution/qwen-tts-hf)和 [faster-qwen3-tts](https://github.com/andimarafioti/faster-qwen3-tts),维护本地推理代码、加速、Studio 和集成功能。请查看[来源及同步说明](docs/UPSTREAMS.md)。
项目代码采用 Apache-2.0。模型与完整 Docker 分发还受各组件条款约束;请保留 [LICENSE](LICENSE)、[NOTICE](NOTICE)、[第三方声明](THIRD_PARTY_NOTICES.md)及[许可指南](docs/LICENSING.md)。项目许可不会替代这些义务。
版本历史
最新统一[版本历史](README.md#version-history)在主文档中维护。