English · Norsk bokmål · Polski · 日本語 · 简体中文 · Español
🎧 Posłuchaj przykładów głosów
# Hangry Labs Faster Qwen3-TTS Studio
Lokalne projektowanie i klonowanie głosu oraz generowanie mowy Qwen3-TTS w kontenerze Docker, z interfejsem przeglądarkowym, odtwarzaniem strumieniowym i HTTP API.
Aktualną wersję, historię zmian i stan publikacji znajdziesz w [głównej dokumentacji angielskiej](README.md).
## Szybki start
Mając Docker, obsługę GPU NVIDIA i sterownik zgodny z CUDA 12.8, uruchom jedną komendę:
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0@sha256:a8a3643b077e05c2ccf33e9b97978f082d2e89ac33b3d1368ab0e25df628899d
```
Otwórz **[http://localhost:7860](http://localhost:7860)** i zacznij generować mowę. Pełny obraz zawiera pięć przypiętych modeli i po pobraniu może działać bez sieci. Wolumin zachowuje modele, zapisane głosy i skrypty.
Mniejsze pobieranie: obraz tiny
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0_tiny@sha256:29f06b3226da4a55244727e111e7700786e53049a54560efeef4bb12a62bd0bd
```
Tiny pobiera modele do tego samego woluminu przy pierwszym użyciu. Zachowaj połączenie z siecią do zapisania wybranych modeli. Wybierz full albo tiny.
Nie potrzebujesz Gita, Pythona na hoście ani ręcznej instalacji modeli. Zobacz [budowanie ze źródeł](docs/DEVELOPMENT.md#build-from-source), [widok API](http://localhost:7860/docs) i [dokumentację Docker Hub](docs/dockerhub.md).
## Możliwości
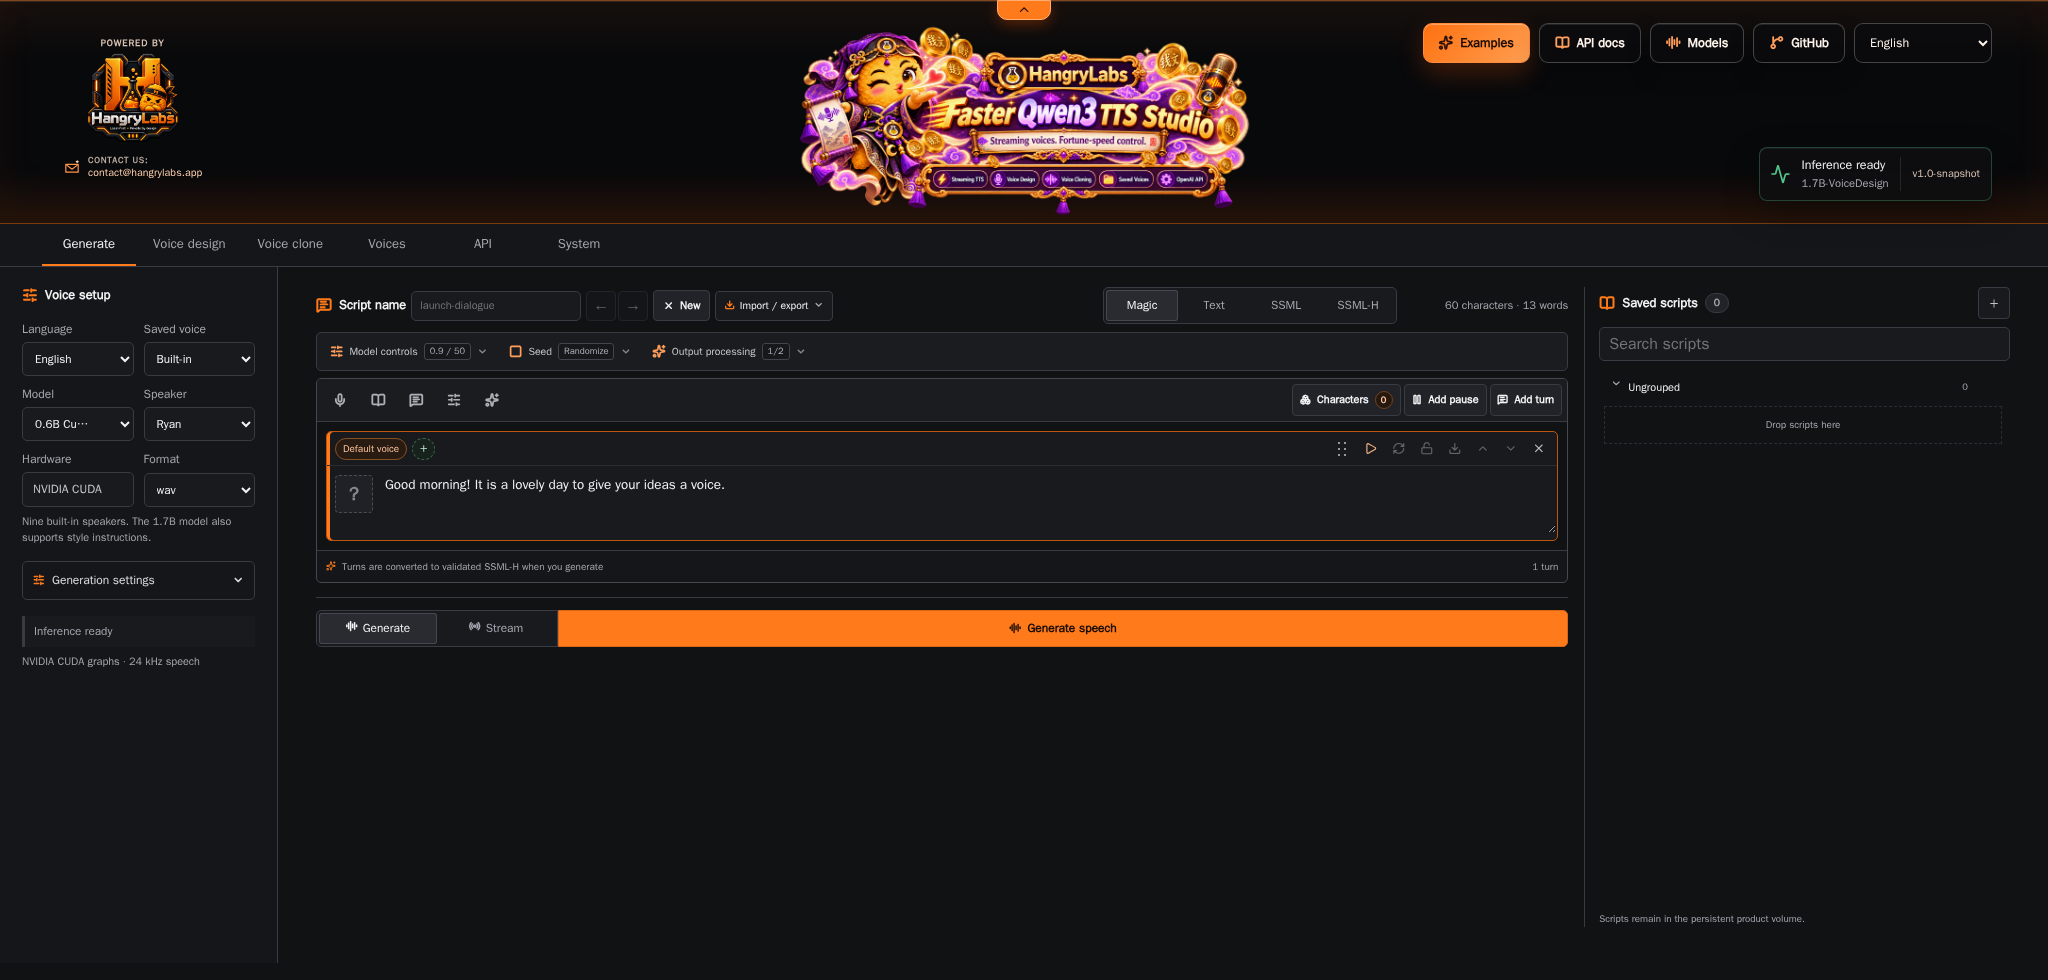
- Projektowanie głosu z opisu przez 1.7B VoiceDesign.
- Klonowanie dozwolonych nagrań przez 0.6B lub 1.7B Base, z opcjonalną eksperymentalną reżyserią.
- Dziewięć głosów CustomVoice; instrukcje stylu dla wbudowanych głosów wymagają 1.7B.
- Tekst, SSML, SSML-H i wizualny edytor dialogów Magic z postaciami i zachowywanymi ujęciami.
- Biblioteka głosów z portretami, tagami, oryginalnymi i przetworzonymi próbkami oraz ustawieniami do dalszego dopracowywania.
- Przesyłanie i nagrywanie audio, przycinanie przebiegów, efekty FFmpeg i pobieranie nagrań.
- API mowy zgodne z OpenAI, natywne API oraz opcjonalne kompaktowe i zaawansowane MCP.
- Kolejka FIFO, anulowanie, diagnostyka czasów, wybór modeli i kontrola pamięci GPU w Systemie.
Interfejs jest dostępny po angielsku, norwesku bokmål, polsku, japońsku, chińsku uproszczonym i hiszpańsku. Zmiana języka zachowuje niezapisany tekst, próbki i wygenerowane audio. Preferencja pozostaje w przeglądarce. Bezpośredni adres: [/pl](http://localhost:7860/pl).
**Język interfejsu i język mowy są niezależne.** Qwen obsługuje chiński, angielski, japoński, koreański, niemiecki, francuski, rosyjski, portugalski, hiszpański i włoski oraz automatyczny wybór języka. Polski i norweski są językami interfejsu, nie obsługiwanymi językami mowy. Przykłady odpowiadają wybranemu językowi mowy; Auto używa przykładu angielskiego.
## Modele i pamięć
| Rodzina | Rozmiary | Zastosowanie |
| --- | --- | --- |
| Base | 0.6B, 1.7B | Klonowanie próbki głosu |
| CustomVoice | 0.6B, 1.7B | Dziewięć wbudowanych głosów |
| VoiceDesign | 1.7B | Nowy głos z opisu |
Domyślnie 0.6B Base, 0.6B CustomVoice i 1.7B VoiceDesign pozostają w pamięci GPU. W Systemie wybierz domyślny model i stałe wczytanie dla każdego zadania albo wyłącz zachowywanie wag. Inferencja wykonuje żądania kolejno. Wspieranym sprzętem są GPU NVIDIA z Torch, Pythonem 3.13 i CUDA 12.8.
Dokładna transkrypcja próbki jest zalecana do klonowania. Reżyseria w Base jest eksperymentalna; tryb samej tożsamości głosu może ją ignorować. Opcjonalne ASR wymaga zewnętrznej usługi. Lokalny model ASR nie jest uruchamiany.
## API
```bash
curl http://localhost:7860/v1/audio/speech -H "Content-Type: application/json" -d '{"model":"qwen3-tts","input":"Hello from Qwen Studio.","voice":"Ryan","response_format":"mp3"}' --output speech.mp3
```
API obsługuje MP3, WAV, FLAC, Opus, AAC, Ogg i PCM. Strumieniowanie w przeglądarce używa MP3. Szczegóły: [API](docs/API.md), [SSML-H](docs/SSML-H.md), [MCP](docs/MCP.md) i [Studio](docs/STUDIO.md). Przewodniki techniczne są utrzymywane po angielsku.
## Prywatność i odpowiedzialne użycie
Klonuj wyłącznie głosy osób, które wyraziły zgodę. Nie używaj syntetycznej mowy do oszukańczego podszywania się pod innych. Próbki i skrypty są zapisywane po jawnym wybraniu zapisu; linki audio MCP są tymczasowe. Zewnętrzne ASR otrzymuje nagrania wysłane przez ciebie do transkrypcji, więc wybierz zaufaną usługę. Zachowaj powiązanie portu z localhost lub zabezpiecz usługę dostępną w sieci uwierzytelnianiem i odpowiednim proxy.
## Pomiary, źródła i licencje
[Benchmarki](benchmarks/README.md) zawierają zmierzoną szybkość, VRAM i opóźnienia strumieniowania. Wyniki nie gwarantują identycznego działania na każdym GPU i głosie.
Utrzymujemy lokalny kod inferencji, przyspieszenie, Studio i integracje na podstawie [Qwen3-TTS](https://github.com/QwenLM/Qwen3-TTS), [gałęzi zgodności qwen-tts-hf](https://github.com/andimarafioti/Qwen3-TTS/tree/distribution/qwen-tts-hf) i [faster-qwen3-tts](https://github.com/andimarafioti/faster-qwen3-tts). Zobacz [pochodzenie i synchronizację](docs/UPSTREAMS.md).
Kod projektu korzysta z Apache-2.0. Modele i pełna dystrybucja Docker mają dodatkowe warunki komponentów. Zachowaj [LICENSE](LICENSE), [NOTICE](NOTICE), [informacje o komponentach](THIRD_PARTY_NOTICES.md) i [zasady licencjonowania](docs/LICENSING.md). Licencja projektu nie zastępuje tych zobowiązań.
Historia wersji
Aktualna, wspólna [historia wersji](README.md#version-history) znajduje się w głównej dokumentacji.