English · Norsk bokmål · Polski · 日本語 · 简体中文 · Español
🎧 Escuchar ejemplos de voz
# Hangry Labs Faster Qwen3-TTS Studio
Diseño de voz, clonación y generación de habla con Qwen3-TTS en un Studio local empaquetado con Docker, con interfaz web, reproducción en streaming y API HTTP.
Consulta la versión actual, el historial y el estado de publicación en el [README principal en inglés](README.md).
## Inicio rápido
Con Docker, soporte para GPU NVIDIA y un controlador compatible con CUDA 12.8, ejecuta un solo comando:
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0@sha256:a8a3643b077e05c2ccf33e9b97978f082d2e89ac33b3d1368ab0e25df628899d
```
Abre **[http://localhost:7860](http://localhost:7860)** y empieza a generar voz. La imagen completa incluye los cinco modelos fijados y funciona sin conexión después de descargarla. El volumen conserva los modelos, las voces guardadas y los guiones.
Descarga menor: imagen tiny
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0_tiny@sha256:29f06b3226da4a55244727e111e7700786e53049a54560efeef4bb12a62bd0bd
```
Tiny descarga los modelos en el mismo volumen al usarlos por primera vez. Mantén la conexión hasta que los modelos elegidos estén en caché. Elige full o tiny.
No necesitas Git, Python en el equipo anfitrión ni configurar modelos manualmente. Consulta [compilar desde el código fuente](docs/DEVELOPMENT.md#build-from-source), la [vista de API](http://localhost:7860/docs) y la [guía de Docker Hub](docs/dockerhub.md).
## Funciones
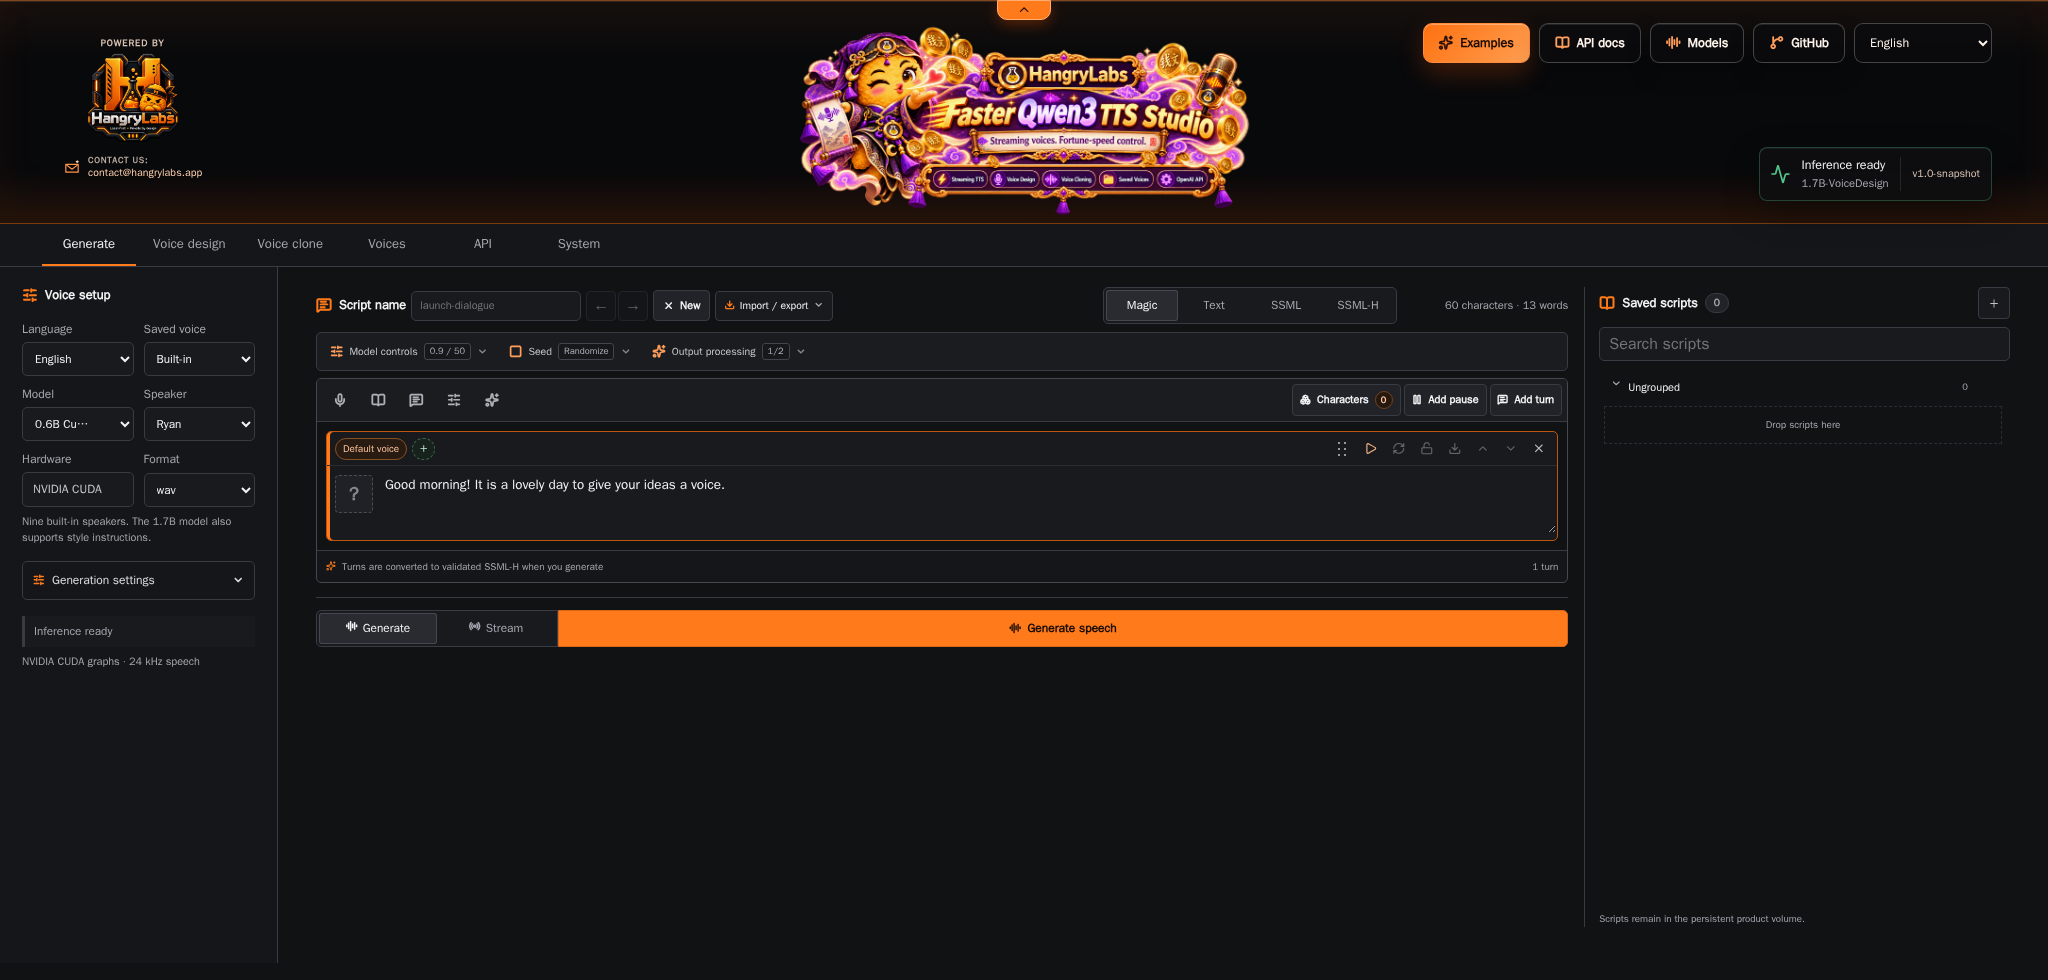
- Diseño de voces a partir de descripciones con 1.7B VoiceDesign.
- Clonación de referencias autorizadas con 0.6B o 1.7B Base e instrucciones de expresión experimentales opcionales.
- Nueve voces integradas de CustomVoice; las instrucciones de estilo para estas voces requieren 1.7B.
- Texto, SSML, SSML-H y diálogos visuales con Magic, personajes, tomas por intervención y reutilización de audio.
- Biblioteca de voces con retratos, etiquetas, referencias originales y procesadas, y ajustes de creación que se pueden restaurar para refinar la voz.
- Carga y grabación de audio, recorte de formas de onda, efectos FFmpeg y descarga.
- API de voz compatible con OpenAI, API nativa y acceso MCP compacto o avanzado opcional.
- Cola FIFO, cancelación, diagnóstico de tiempos y controles de modelos y memoria GPU en Sistema.
La interfaz está disponible en inglés, noruego bokmål, polaco, japonés, chino simplificado y español. Cambiar el idioma conserva el texto sin guardar, las referencias y el audio generado. La preferencia se guarda en el navegador. Enlace directo: [/es](http://localhost:7860/es).
**El idioma de la interfaz y el idioma de voz son independientes.** Qwen admite chino, inglés, japonés, coreano, alemán, francés, ruso, portugués, español e italiano, además de selección automática. El noruego y el polaco solo son idiomas de interfaz. Los ejemplos siguen el idioma de voz elegido; Auto usa un ejemplo en inglés.
## Modelos y memoria
| Familia | Tamaños | Uso |
| --- | --- | --- |
| Base | 0.6B, 1.7B | Clonación desde una referencia de audio |
| CustomVoice | 0.6B, 1.7B | Nueve voces integradas |
| VoiceDesign | 1.7B | Voz nueva a partir de una descripción |
Por defecto se mantienen 0.6B Base, 0.6B CustomVoice y 1.7B VoiceDesign en la memoria GPU. En Sistema puedes elegir el modelo predeterminado y su residencia para cada flujo, o desactivar la retención de pesos. Las solicitudes se ejecutan en serie en una cola compartida. El objetivo es NVIDIA con Torch, Python 3.13 y CUDA 12.8.
Se recomienda una transcripción exacta de la referencia para clonar. Las instrucciones de Base son experimentales y el modo de identidad de voz puede ignorarlas. El ASR opcional necesita un servicio externo configurado; no se inicia un modelo ASR local.
## API
```bash
curl http://localhost:7860/v1/audio/speech -H "Content-Type: application/json" -d '{"model":"qwen3-tts","input":"Hello from Qwen Studio.","voice":"Ryan","response_format":"mp3"}' --output speech.mp3
```
La API ofrece MP3, WAV, FLAC, Opus, AAC, Ogg y PCM. El streaming del navegador usa MP3. Consulta las guías de [API](docs/API.md), [SSML-H](docs/SSML-H.md), [MCP](docs/MCP.md) y [Studio](docs/STUDIO.md). Estas guías técnicas se mantienen en inglés.
## Privacidad y uso responsable
Clona voces solo con consentimiento y no uses voz sintética para suplantaciones engañosas. Las referencias y los guiones se conservan al guardarlos explícitamente; los enlaces de audio MCP son temporales. El ASR externo recibe las grabaciones que envías para transcribir, por lo que debes elegir un servicio de confianza. Mantén el puerto limitado a localhost o protege la exposición en red con autenticación y un proxy adecuado.
## Mediciones, proyectos originales y licencias
Los [benchmarks](benchmarks/README.md) documentan velocidad, VRAM y latencia de streaming medidas. Los resultados no garantizan el mismo rendimiento en todas las GPU y voces.
Mantenemos la inferencia local, la aceleración, Studio y las integraciones a partir de [Qwen3-TTS](https://github.com/QwenLM/Qwen3-TTS), la [rama de compatibilidad qwen-tts-hf](https://github.com/andimarafioti/Qwen3-TTS/tree/distribution/qwen-tts-hf) y [faster-qwen3-tts](https://github.com/andimarafioti/faster-qwen3-tts). Consulta la [procedencia y sincronización](docs/UPSTREAMS.md).
El código del proyecto usa Apache-2.0. Los modelos y la distribución Docker completa incluyen condiciones adicionales de sus componentes. Conserva [LICENSE](LICENSE), [NOTICE](NOTICE), los [avisos de terceros](THIRD_PARTY_NOTICES.md) y la [guía de licencias](docs/LICENSING.md). La licencia del proyecto no sustituye estas obligaciones.
Historial de versiones
El [historial común actualizado](README.md#version-history) se mantiene en el README principal.