English · Norsk bokmål · Polski · 日本語 · 简体中文 · Español
🎧 音声サンプルを聴く
# Hangry Labs Faster Qwen3-TTS Studio
Qwen3-TTS による声のデザイン、声のクローン、音声生成をローカルで行う Docker 版 Studio。ブラウザー UI、ストリーミング再生、HTTP API を提供します。
最新のバージョン、変更履歴、公開状況は[英語のメイン README](README.md)を確認してください。
## クイックスタート
Docker、NVIDIA GPU 対応、CUDA 12.8 に対応するドライバーがあれば、次の 1 コマンドで起動できます。
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0@sha256:a8a3643b077e05c2ccf33e9b97978f082d2e89ac33b3d1368ab0e25df628899d
```
**[http://localhost:7860](http://localhost:7860)** を開いて音声を生成します。完全版には固定リビジョンのモデルが 5 つ含まれ、イメージ取得後はオフラインで動作します。モデル、保存した声、台本はボリュームに保持します。
ダウンロード容量を抑える:tiny イメージ
```bash
docker run -d --name faster-qwen3-tts-studio --restart unless-stopped -p 127.0.0.1:7860:7860 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v faster_qwen3_tts_studio_data:/app/persistent hangrylabs/faster-qwen3-tts-studio:v1.0_tiny@sha256:29f06b3226da4a55244727e111e7700786e53049a54560efeef4bb12a62bd0bd
```
Tiny は初回使用時に同じボリュームへモデルを取得します。選択したモデルのキャッシュが完了するまでネットワークに接続してください。full または tiny のいずれかを選びます。
Git、ホストの Python、手動のモデル設定は不要です。開発には[ソースからのビルド](docs/DEVELOPMENT.md#build-from-source)、連携には [API ビュー](http://localhost:7860/docs)や [Docker Hub ガイド](docs/dockerhub.md)を参照してください。
## 主な機能
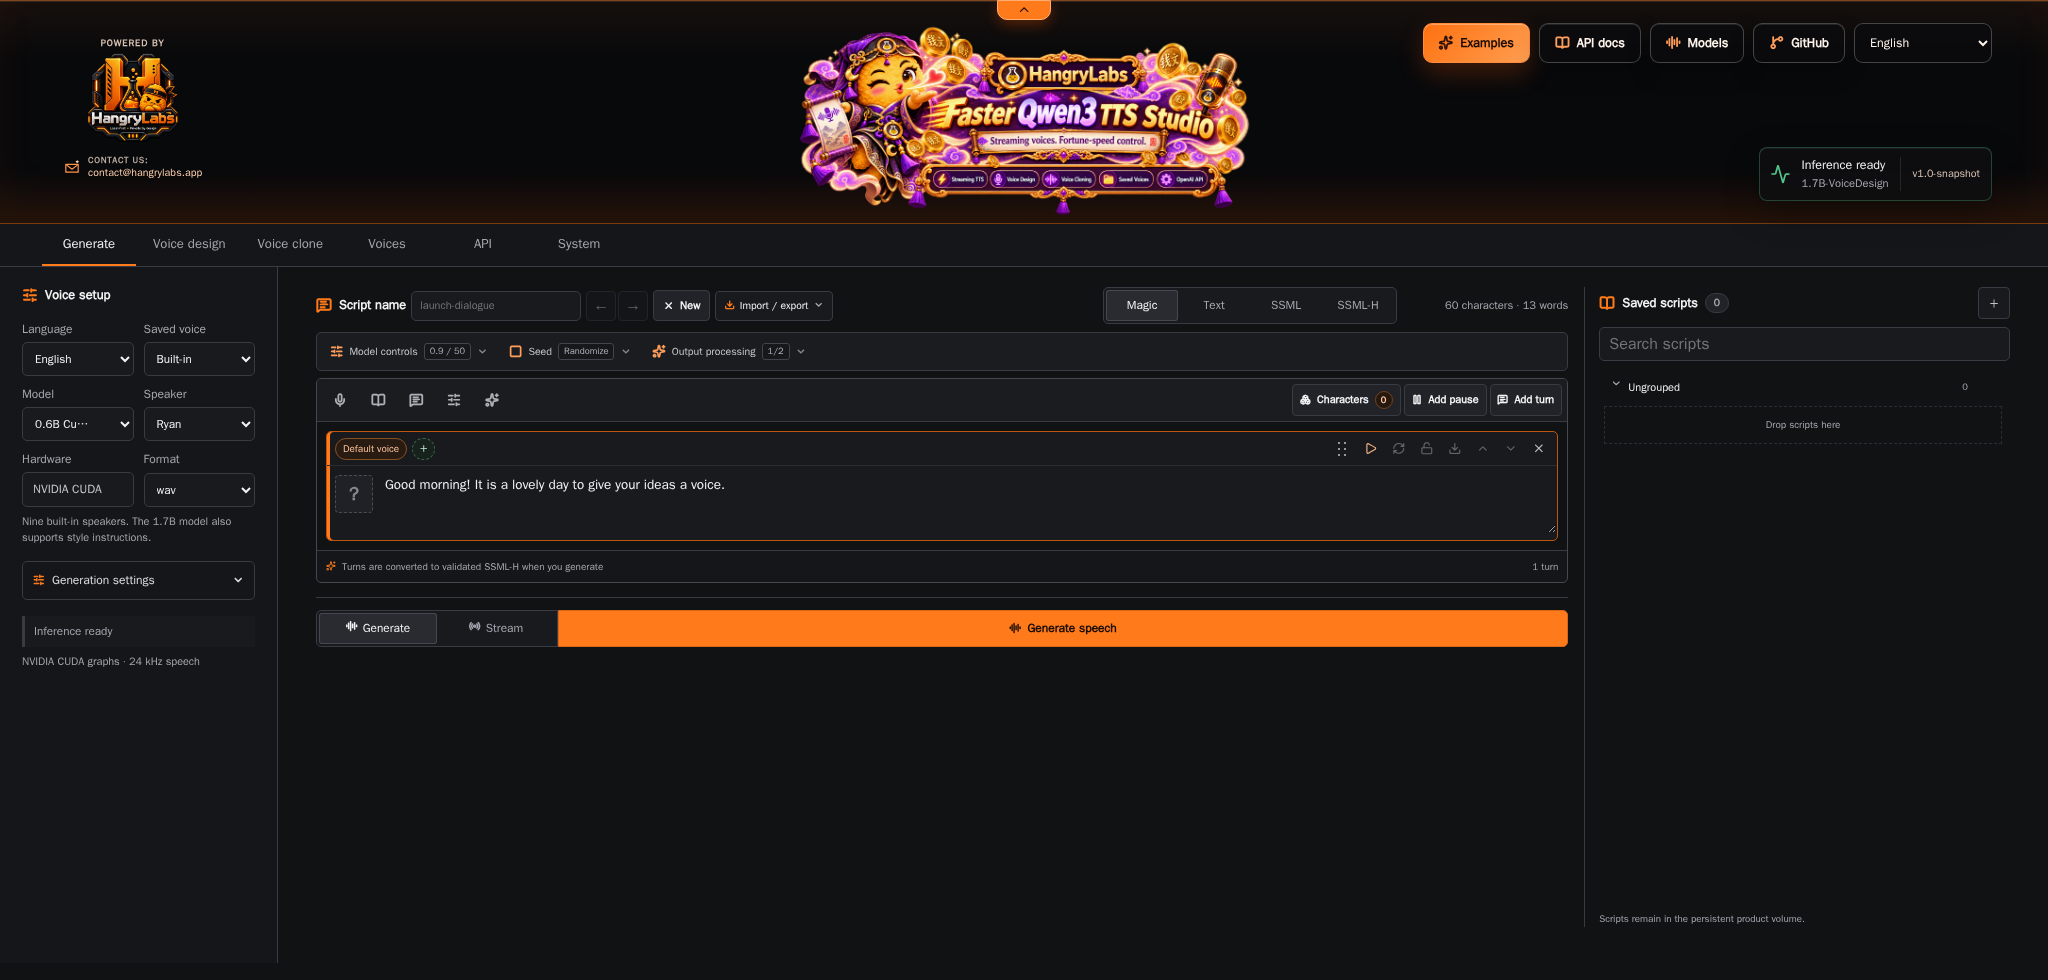
- 1.7B VoiceDesign による、自然言語の説明からの声のデザイン。
- 0.6B / 1.7B Base による、使用許可のある参照音声からのクローン。実験的な話し方の指示も利用可能。
- CustomVoice の 9 種類の内蔵話者。内蔵話者へのスタイル指示は 1.7B が必要。
- テキスト、SSML、SSML-H、Magic 会話エディター。キャラクター、台詞ごとのテイク、テイクの再利用。
- ポートレート、タグ、元の音声と加工済み音声、作成設定を保存し、声を再調整できるライブラリ。
- 音声のアップロードと録音、波形のトリミング、FFmpeg エフェクト、ダウンロード。
- OpenAI 互換音声 API、ネイティブ API、任意で有効にできるコンパクト版・詳細版 MCP。
- FIFO キュー、キャンセル、時間の診断、System でのモデル選択と GPU メモリ管理。
UI は英語、ノルウェー語ブークモール、ポーランド語、日本語、簡体字中国語、スペイン語に対応します。言語を切り替えても、未保存のテキスト、参照録音、生成音声は保持されます。設定はブラウザー内に保存します。直接開く場合は [/ja](http://localhost:7860/ja) を使います。
**UI の言語と音声の言語は別の設定です。** Qwen の音声は中国語、英語、日本語、韓国語、ドイツ語、フランス語、ロシア語、ポルトガル語、スペイン語、イタリア語と自動選択に対応します。ノルウェー語とポーランド語は UI のみです。例文は選択した音声言語に従い、Auto では英語の例文を使います。
## モデルとメモリ
| 系列 | サイズ | 用途 |
| --- | --- | --- |
| Base | 0.6B、1.7B | 参照音声からの声のクローン |
| CustomVoice | 0.6B、1.7B | 9 種類の内蔵話者 |
| VoiceDesign | 1.7B | 説明から新しい声を作成 |
既定では 0.6B Base、0.6B CustomVoice、1.7B VoiceDesign を GPU メモリに保持します。System でワークフローごとの既定モデルと常駐設定を変更するか、重みの保持を無効にできます。推論は共有キューで直列実行します。対象は NVIDIA GPU と Torch、Python 3.13、CUDA 12.8 です。
クローンには参照音声の正確な文字起こしを推奨します。Base の話し方の指示は実験的で、話者の特徴のみを使う場合は反映されないことがあります。ASR は任意の外部サービスを設定して使用します。ローカル ASR モデルは起動しません。
## API
```bash
curl http://localhost:7860/v1/audio/speech -H "Content-Type: application/json" -d '{"model":"qwen3-tts","input":"Hello from Qwen Studio.","voice":"Ryan","response_format":"mp3"}' --output speech.mp3
```
音声 API は MP3、WAV、FLAC、Opus、AAC、Ogg、PCM に対応します。ブラウザーのストリーミングは MP3 を使います。詳細は [API](docs/API.md)、[SSML-H](docs/SSML-H.md)、[MCP](docs/MCP.md)、[Studio ガイド](docs/STUDIO.md)を参照してください。技術ガイドは英語で管理しています。
## プライバシーと責任ある利用
声のクローンには本人の同意が必要です。合成音声を、人を欺くなりすましに使わないでください。参照音声と台本は明示的に保存した時に保存され、MCP の音声リンクは一時的です。文字起こしを実行すると選択した外部 ASR に録音を送信するため、信頼できるサービスを設定してください。ポートは localhost に限定するか、ネットワーク公開時は認証と適切なプロキシで保護してください。
## ベンチマーク、上流、ライセンス
測定済みの速度、VRAM、ストリーミング遅延は[ベンチマーク](benchmarks/README.md)にあります。すべての GPU や声で同じ結果になるとは限りません。
[Qwen3-TTS](https://github.com/QwenLM/Qwen3-TTS)、[qwen-tts-hf 互換ブランチ](https://github.com/andimarafioti/Qwen3-TTS/tree/distribution/qwen-tts-hf)、[faster-qwen3-tts](https://github.com/andimarafioti/faster-qwen3-tts) を基に、ローカル推論、アクセラレーション、Studio、連携機能を保守しています。[出典と同期方針](docs/UPSTREAMS.md)を参照してください。
プロジェクトのコードは Apache-2.0 です。モデルと Docker 配布物全体には各コンポーネントの条件も適用されます。[LICENSE](LICENSE)、[NOTICE](NOTICE)、[サードパーティ通知](THIRD_PARTY_NOTICES.md)、[ライセンスガイド](docs/LICENSING.md)を保持してください。プロジェクトのライセンスがこれらの義務を置き換えることはありません。
バージョン履歴
最新の共通[バージョン履歴](README.md#version-history)はメイン README で管理しています。