<p align="center">
  <a href="https://hangry-labs.github.io/VoxCPMTTS/examples/">
    <img src="assets/voxcpmtts_logo_horizontal.webp" alt="Hangry Labs VoxCPMTTS 标志" width="900">
  </a>
</p>

<p align="center">
  <a href="README.md">English</a> ·
  <a href="README.nb.md">Norsk bokmål</a> ·
  <a href="README.pl.md">Polski</a> ·
  <a href="README.ja.md">日本語</a> ·
  <strong>简体中文</strong> ·
  <a href="README.es.md">Español</a>
</p>

<p align="center"><a href="https://hangry-labs.github.io/VoxCPMTTS/examples/?lang=zh"><strong>🎧 收听语音示例</strong></a></p>

# Hangry Labs VoxCPMTTS

开箱即用的多语言文本转语音 Docker 软件包，包含 Nano-vLLM 推理、本地浏览器界面和 HTTP API。

此 Hangry Labs 版本专为简便的本地使用而设计。启动一个容器，即可通过界面或 API 生成语音，无需手动配置 Python、模型和音频工具。

## 项目功能

- 支持语音生成、流式输出、声音设计、声音克隆、本地转写，以及对声音和生成音频进行可选非破坏性处理的浏览器界面
- 持久化声音配置和对话脚本，支持设计参数、头像、搜索、SSML-H 导入导出以及跨会话重复使用
- 使用 SSML 和 SSML-H 创建旁白、多角色对话和广播剧
- OpenAI 兼容语音 API（`/v1/audio/speech`）以及面向应用程序和本地集成的原生 HTTP API
- 可选的 MCP 端点（`/mcp/` 和 `/mcp/advanced/`），通过限时音频链接与其他本地服务集成
- 支持 VoxCPM2 的 30 种语言
- 输出 WAV、MP3、FLAC、OGG、Opus、AAC 和 PCM
- 使用 CUDA 图加速的 Nano-vLLM 推理
- 默认启用长文本保护，在自然边界处分段，并提供明确的关闭选项
- 完整 Docker 镜像包含离线推理所需的模型资源

**语言：** VoxCPM2 官方支持 [30 种语言和 9 个中文方言组](SUPPORTED_LANGUAGES.md)。

> [!TIP]
> **安装前先试听：** 打开[涵盖 30 种语言的交互式示例库](https://hangry-labs.github.io/VoxCPMTTS/examples/)，体验声音设计、声音克隆和精选 Magic 对话。

> [!IMPORTANT]
> 项目自有及上游衍生源代码采用 Apache-2.0 许可证。Docker 镜像属于聚合发行版，其中还包含模型资源、NVIDIA CUDA 库、FFmpeg 及其他遵循各自条款的软件包。部署或再分发前，请阅读[第三方声明](THIRD_PARTY_NOTICES.md)。

### 可视化构建完整对话脚本

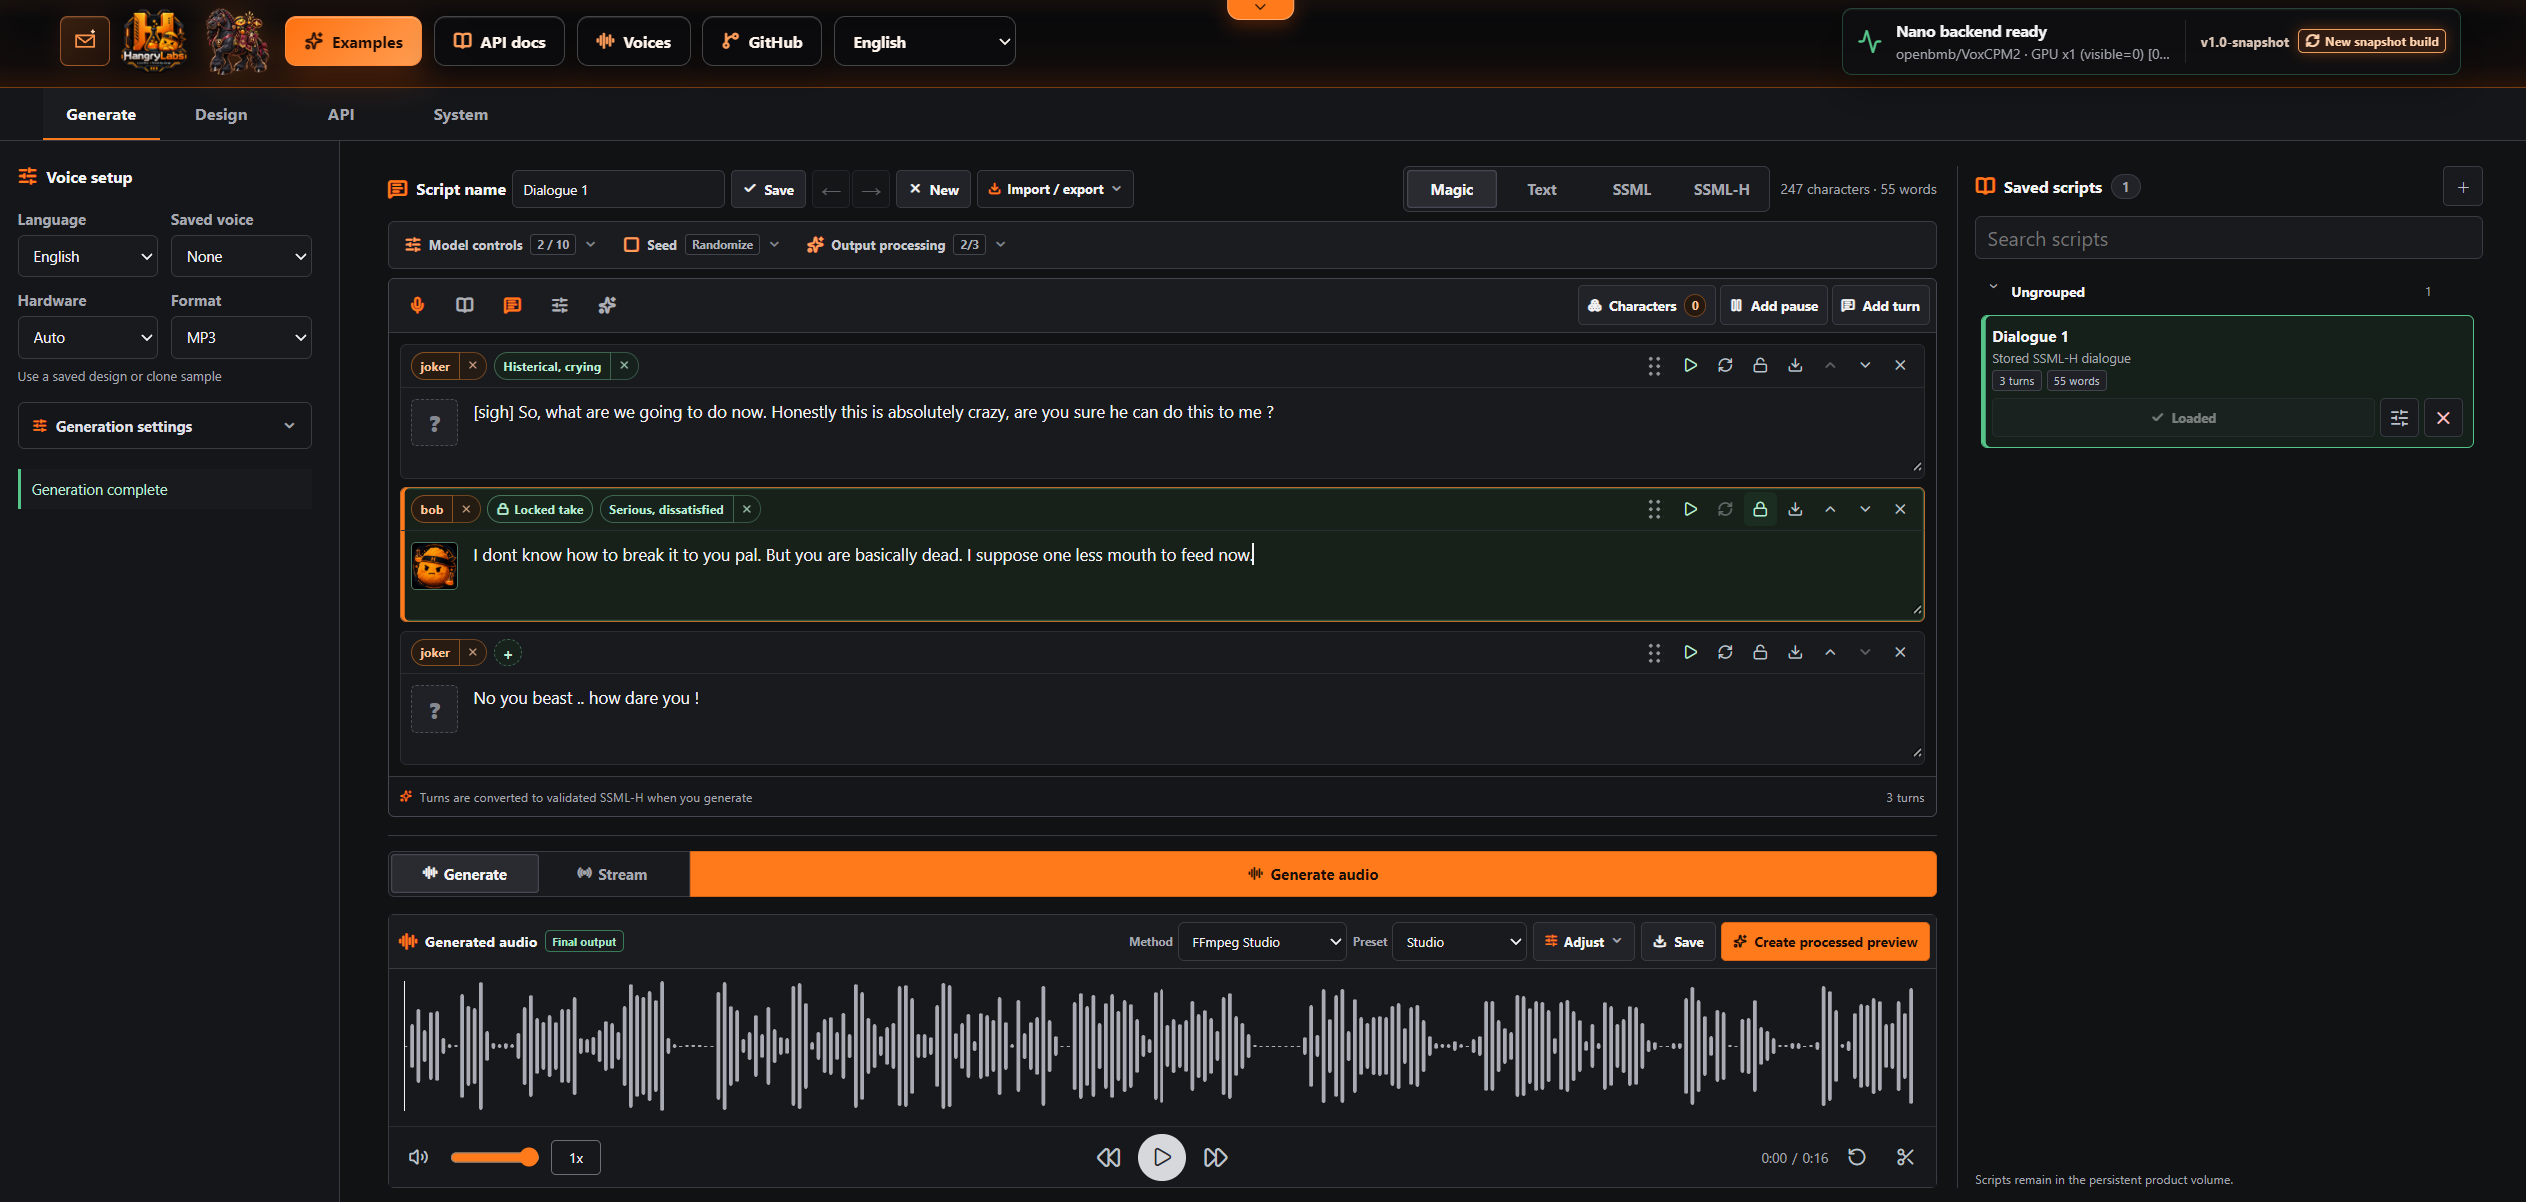
使用 Magic 编辑器直观编排多角色场景，分配已保存或在脚本中定义的声音，控制每段对白的语言、语速、音高、音量和表演方向，标注发音范围，预览单个对白片段，通过拖放调整顺序，并将完整对话保存为可移植的 SSML-H。

<p align="center">
  <a href="assets/screenshots/generate-ui.webp">
    <img src="assets/screenshots/generate-ui.webp" alt="VoxCPMTTS 生成工作区，显示带表演指导的三角色对话和已保存脚本库" width="1200">
  </a>
</p>

### 设计、克隆并重复使用声音

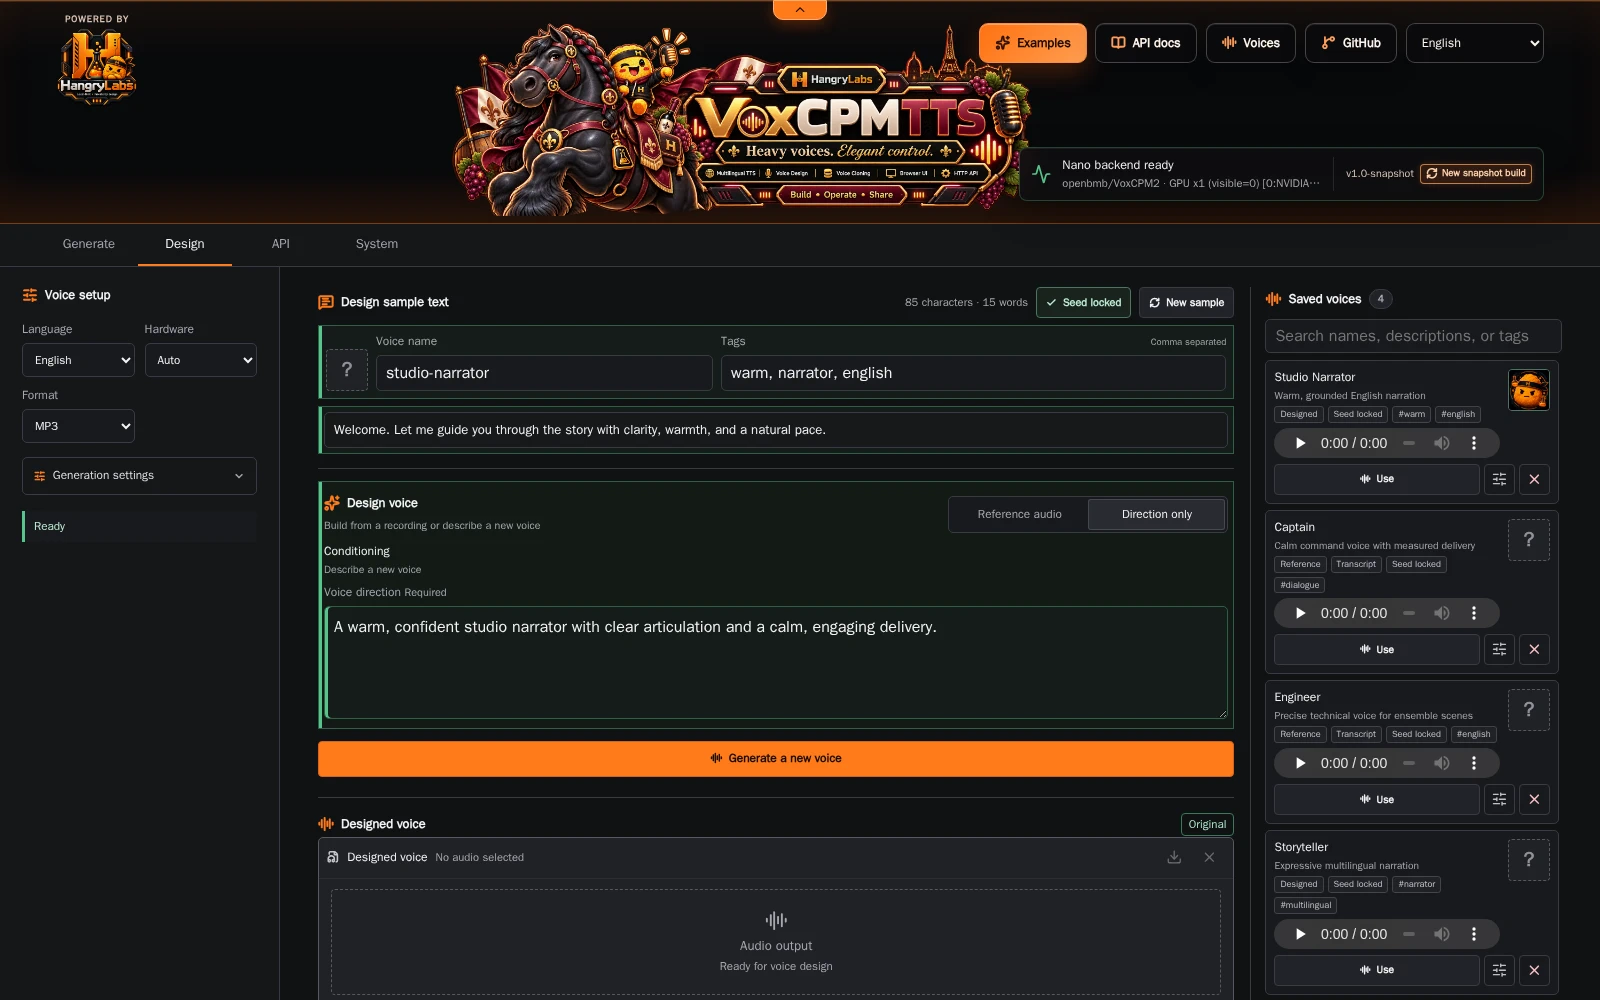
通过自然语言描述或参考录音创建声音，锁定种子以保持一致性，添加头像和标签，优化音频，并在后续脚本中重复使用已保存的角色。

<p align="center">
  <a href="assets/screenshots/design-ui.webp">
    <img src="assets/screenshots/design-ui.webp" alt="VoxCPMTTS 声音设计工作区，显示已锁定种子的录音室旁白声音和可重复使用的声音库" width="1200">
  </a>
</p>

## 快速开始

在 NVIDIA GPU 上运行完整镜像：

```bash
docker run -d --name voxcpmtts --restart unless-stopped -p 8808:8808 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v voxcpmtts_data:/app/persistent hangrylabs/voxcpmtts:v1.1@sha256:cc5a1f186cd8baeed3fe777b94ebe8a22648dbd30d5100a498bad46b860210a9
```

然后打开：

- 界面：[http://localhost:8808/zh](http://localhost:8808/zh)
- API 文档：[http://localhost:8808/tts/docs](http://localhost:8808/tts/docs)
- [语言和声音示例](https://hangry-labs.github.io/VoxCPMTTS/examples/)

`voxcpmtts_data` 卷会在容器替换后保留模型缓存、声音配置、对话脚本、参考音频和未来的设置。完整镜像包含固定的模型资源，下载后可在无网络环境下进行常规推理。

已发布的 GitHub Release 及其 Git 标签不可变。带版本号的 Docker 标签同样不可变，而 `latest` 和 `latest_tiny` 会按设计指向最新快照。

## 更多信息

请阅读[中文产品页和安装指南](https://hangrylabs.app/zh/software/voxcpmtts)。完整技术文档维护在[英文 README](README.md) 中。问题和建议可提交至 [GitHub Issues](https://github.com/Hangry-Labs/VoxCPMTTS/issues)。