<p align="center">
  <a href="https://hangry-labs.github.io/VoxCPMTTS/examples/">
    <img src="assets/voxcpmtts_logo_horizontal.webp" alt="Logo Hangry Labs VoxCPMTTS" width="900">
  </a>
</p>

<p align="center">
  <a href="README.md">English</a> ·
  <a href="README.nb.md">Norsk bokmål</a> ·
  <strong>Polski</strong> ·
  <a href="README.ja.md">日本語</a> ·
  <a href="README.zh.md">简体中文</a> ·
  <a href="README.es.md">Español</a>
</p>

<p align="center"><a href="https://hangry-labs.github.io/VoxCPMTTS/examples/?lang=pl"><strong>🎧 Posłuchaj przykładów głosów</strong></a></p>

# Hangry Labs VoxCPMTTS

Gotowy do użycia w Dockerze, wielojęzyczny system zamiany tekstu na mowę z inferencją Nano-vLLM, lokalnym interfejsem przeglądarkowym i API HTTP.

Ta wersja Hangry Labs została przygotowana z myślą o prostej lokalnej pracy. Uruchom jeden kontener, otwórz interfejs albo użyj API bez ręcznej konfiguracji Pythona, modeli i narzędzi audio.

## Co oferuje projekt

- Interfejs przeglądarkowy do generowania, strumieniowania, projektowania i klonowania głosu, lokalnej transkrypcji oraz opcjonalnego niedestrukcyjnego dopracowania głosu i wygenerowanego nagrania
- Trwałe profile głosowe i skrypty dialogów z recepturami, portretami, wyszukiwaniem, importem i eksportem SSML-H oraz ponownym użyciem między sesjami
- SSML i SSML-H do narracji, dialogów wielu postaci i słuchowisk
- API mowy zgodne z OpenAI (`/v1/audio/speech`) oraz natywne API HTTP dla aplikacji i lokalnych integracji
- Opcjonalne punkty końcowe MCP (`/mcp/` i `/mcp/advanced/`) z wygasającymi odnośnikami audio dla innych lokalnych usług
- Generowanie w 30 językach obsługiwanych przez VoxCPM2
- Formaty WAV, MP3, FLAC, OGG, Opus, AAC i PCM
- Nano-vLLM z akceleracją grafów CUDA
- Domyślna ochrona długich nagrań przez podział w naturalnych miejscach, z wyraźną możliwością wyłączenia
- Pełny obraz Docker zawierający zasoby modelu potrzebne do pracy offline

**Języki:** VoxCPM2 oficjalnie obsługuje [30 języków i dziewięć grup chińskich dialektów](SUPPORTED_LANGUAGES.md).

> [!TIP]
> **Posłuchaj przed instalacją:** Otwórz [interaktywną galerię przykładów w 30 językach](https://hangry-labs.github.io/VoxCPMTTS/examples/), obejmującą projektowanie i klonowanie głosu oraz wyróżniony dialog Magic.

> [!IMPORTANT]
> Kod własny projektu i kod pochodzący z projektu nadrzędnego korzystają z licencji Apache-2.0. Obrazy Docker są jednak dystrybucjami zbiorczymi zawierającymi również zasoby modeli, biblioteki NVIDIA CUDA, FFmpeg i inne pakiety na ich własnych warunkach. Przed wdrożeniem lub redystrybucją przeczytaj [informacje o komponentach zewnętrznych](THIRD_PARTY_NOTICES.md).

### Twórz kompletne scenariusze dialogów

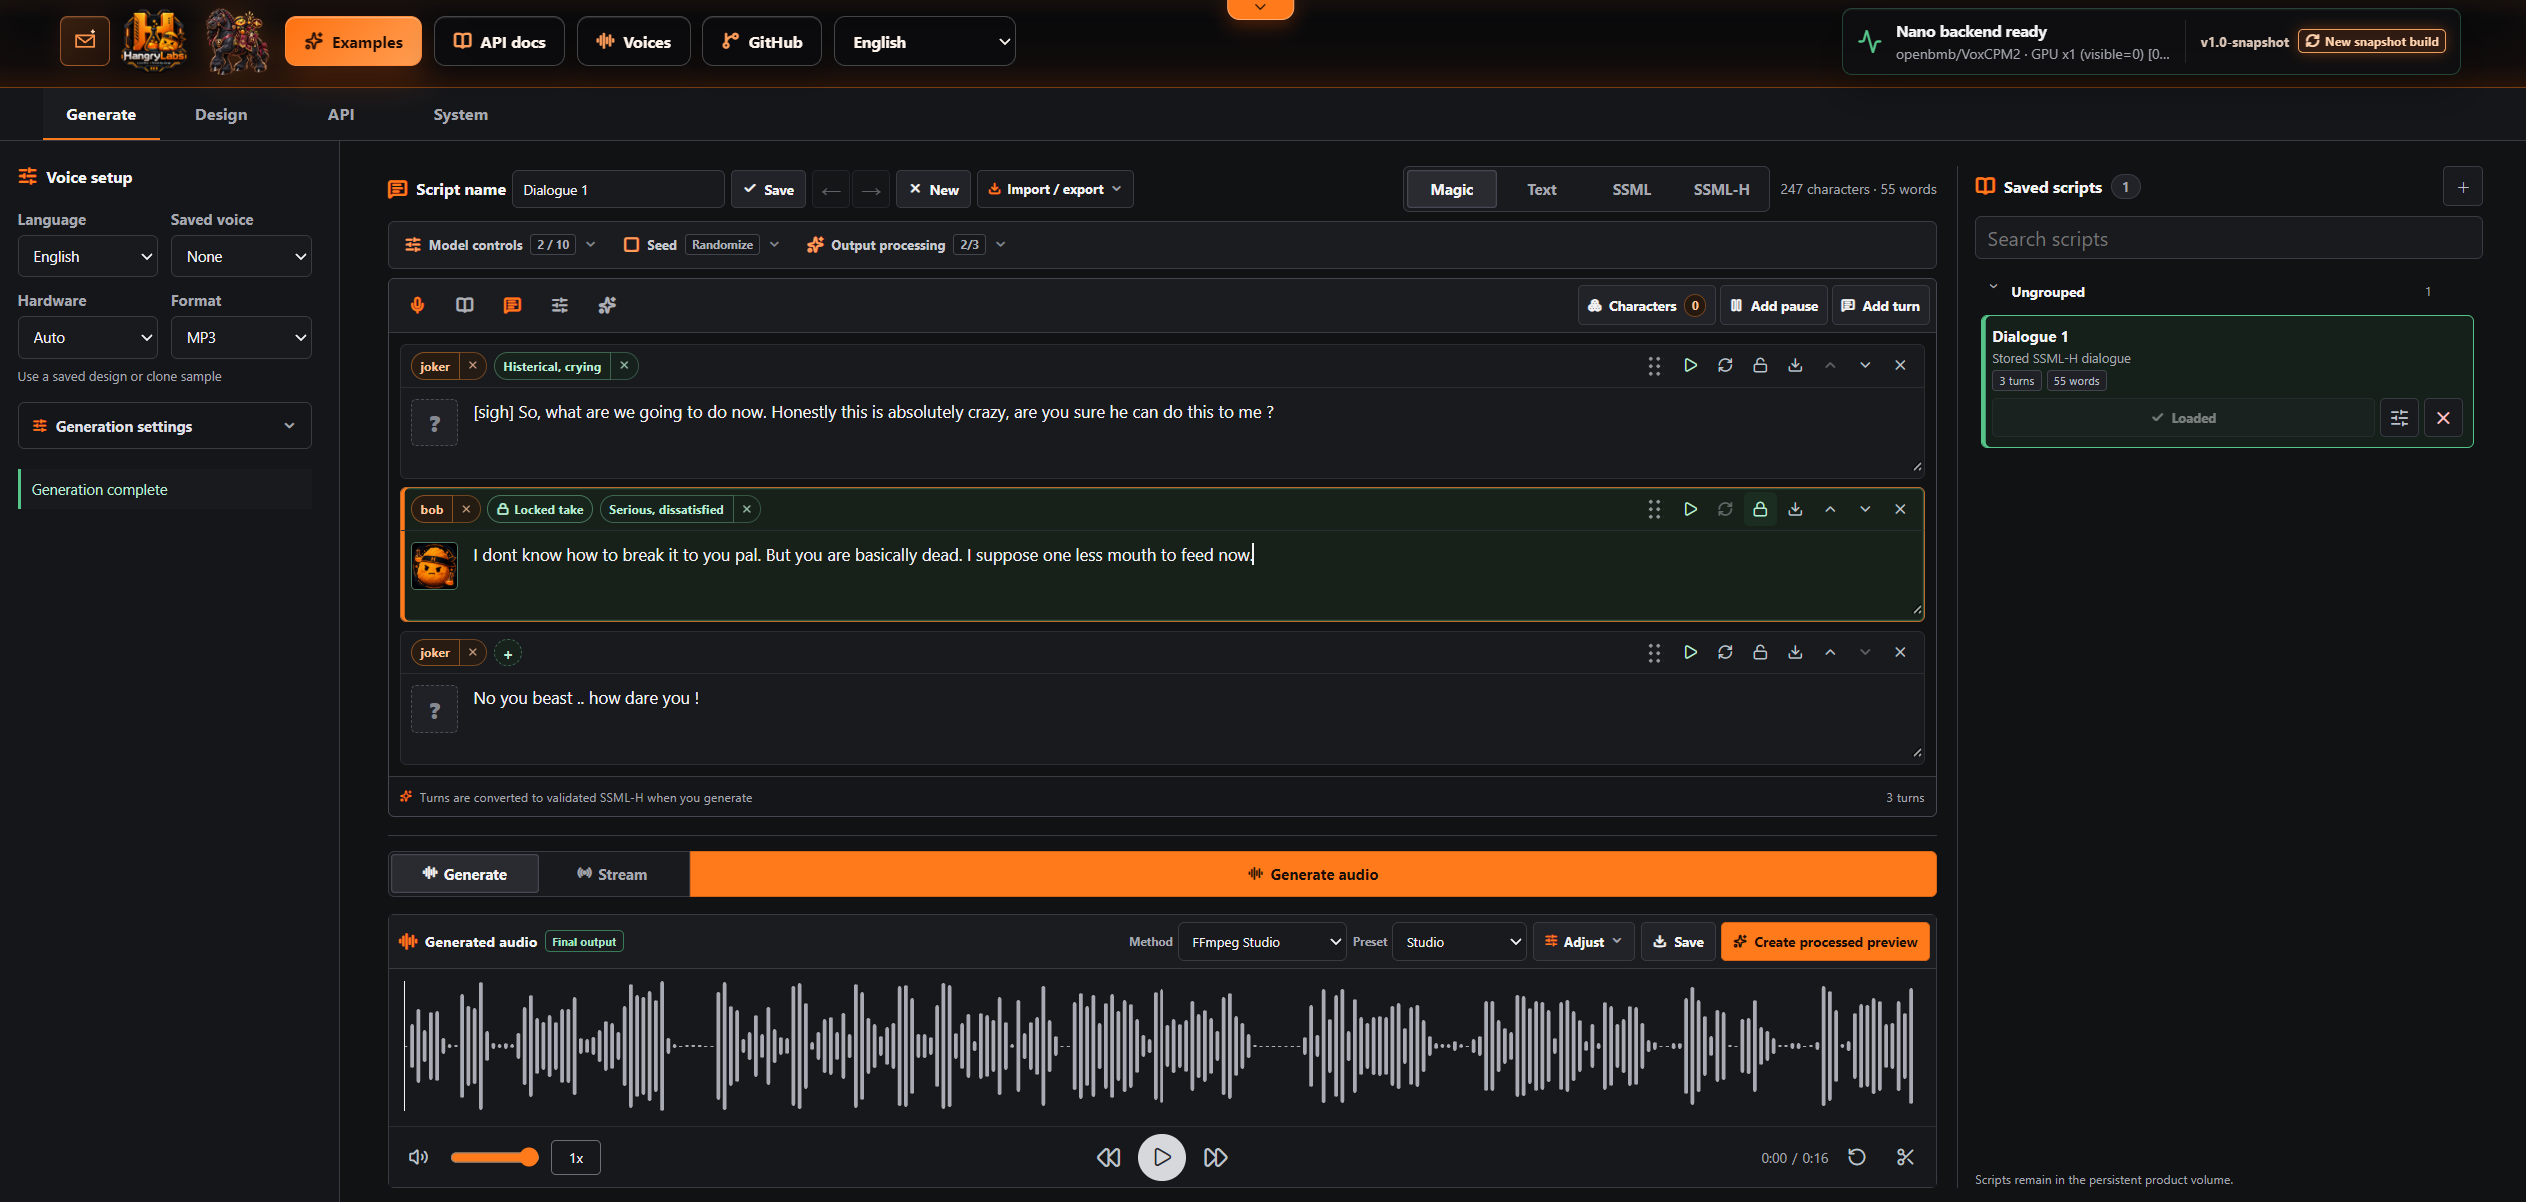
Edytor Magic pozwala wizualnie układać sceny z wieloma mówcami, przypisywać zapisane lub zdefiniowane w skrypcie głosy, ustawiać język, tempo, wysokość, głośność i kierunek każdej kwestii, oznaczać wymowę, odsłuchiwać pojedyncze kwestie, przeciągać je w odpowiedniej kolejności i zapisywać cały dialog jako przenośny dokument SSML-H.
<p align="center">
  <a href="assets/screenshots/generate-ui.webp">
    <img src="assets/screenshots/generate-ui.webp" alt="Interfejs generowania VoxCPMTTS z reżyserowanym dialogiem trzech postaci i biblioteką zapisanych scenariuszy" width="1200">
  </a>
</p>

### Projektuj, klonuj i wykorzystuj głosy ponownie

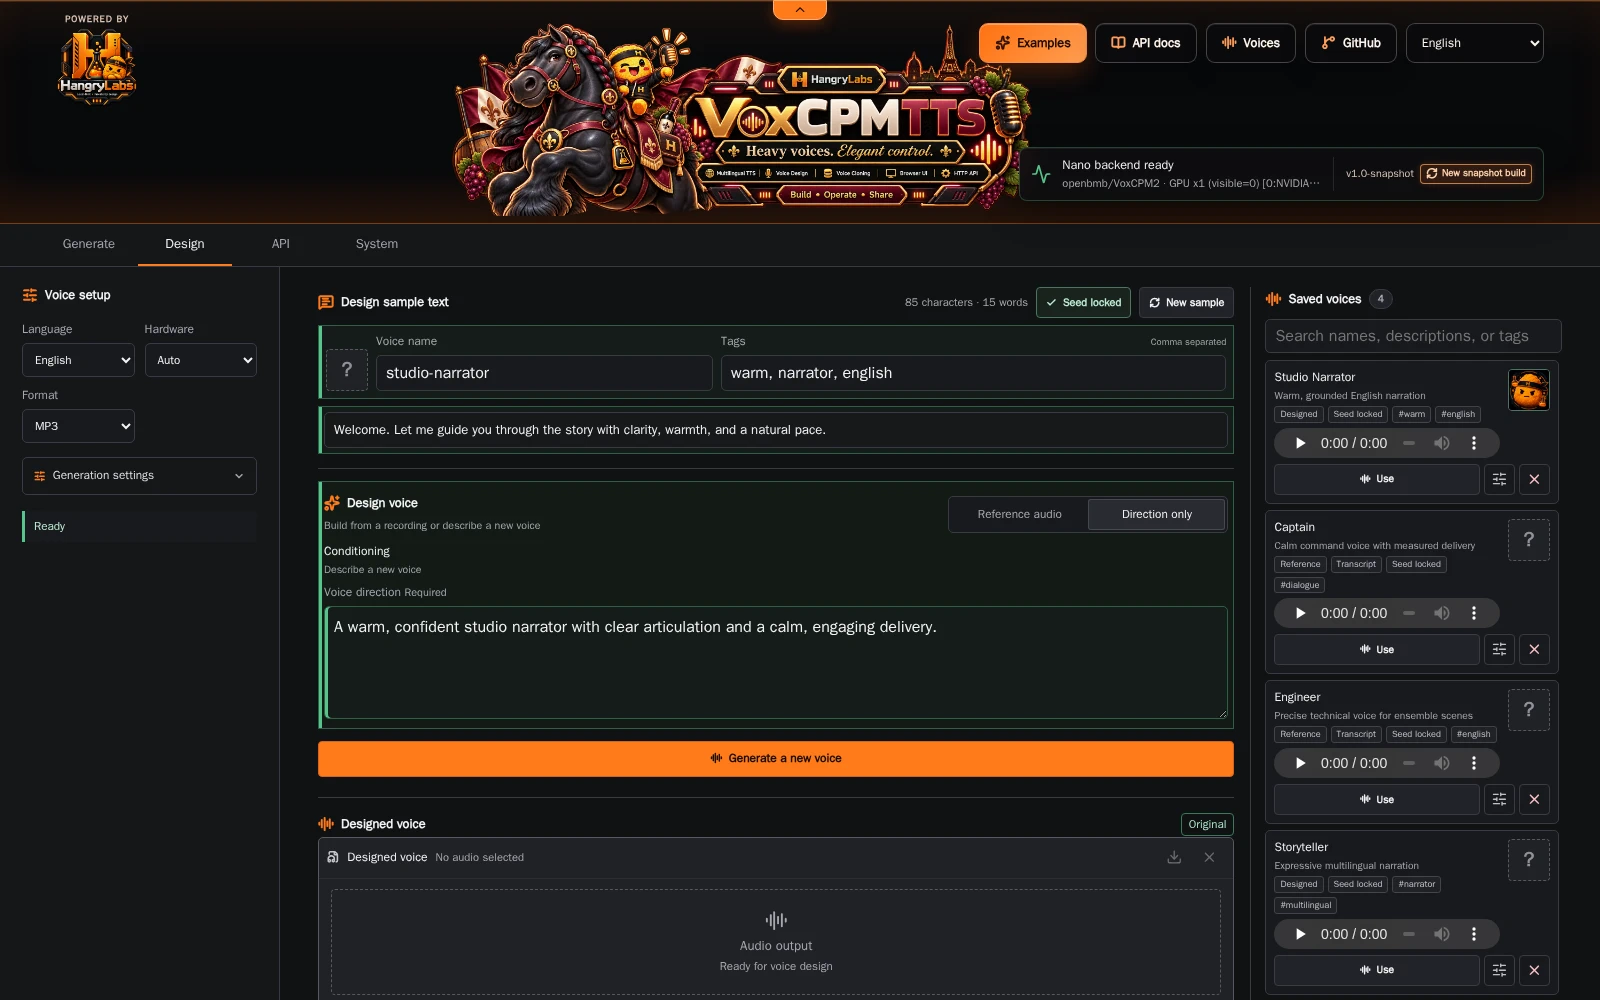
Twórz głosy na podstawie opisu w języku naturalnym lub nagrania referencyjnego, blokuj ziarno dla zachowania spójności, dodawaj portrety i tagi, dopracowuj dźwięk oraz wykorzystuj zapisane postacie w kolejnych scenariuszach.

<p align="center">
  <a href="assets/screenshots/design-ui.webp">
    <img src="assets/screenshots/design-ui.webp" alt="Interfejs projektowania VoxCPMTTS z narratorem studyjnym o zablokowanym ziarnie i biblioteką głosów wielokrotnego użytku" width="1200">
  </a>
</p>

## Szybki start

Uruchom pełny obraz na karcie NVIDIA:

```bash
docker run -d --name voxcpmtts --restart unless-stopped -p 8808:8808 --gpus all -e CUDA_VISIBLE_DEVICES=0 -v voxcpmtts_data:/app/persistent hangrylabs/voxcpmtts:v1.1@sha256:cc5a1f186cd8baeed3fe777b94ebe8a22648dbd30d5100a498bad46b860210a9
```

Następnie otwórz:

- Interfejs: [http://localhost:8808/pl](http://localhost:8808/pl)
- Dokumentację API: [http://localhost:8808/tts/docs](http://localhost:8808/tts/docs)
- [Przykłady języków i głosów](https://hangry-labs.github.io/VoxCPMTTS/examples/)

Wolumin `voxcpmtts_data` zachowuje pamięć podręczną modeli, profile głosowe, dźwięk referencyjny i przyszłe ustawienia po wymianie kontenera. Pełny obraz zawiera przypięte zasoby modeli i po pobraniu może wykonywać zwykłą inferencję bez sieci.

Opublikowane wydania GitHub i powiązane tagi Git są niezmienne. Wersjonowane tagi obrazów Docker również są niezmienne, natomiast `latest` i `latest_tiny` celowo wskazują najnowszą wersję rozwojową.

## Więcej informacji

Przeczytaj [pełny polski opis produktu i instrukcję instalacji](https://hangrylabs.app/pl/software/voxcpmtts). Pełna dokumentacja techniczna jest utrzymywana w [angielskim pliku README](README.md). Błędy i propozycje można zgłaszać w [GitHub Issues](https://github.com/Hangry-Labs/VoxCPMTTS/issues).
