English · Norsk bokmål · Polski · 日本語 · 简体中文 · Español
🎧 Posłuchaj wygenerowanych piosenek
Hangry Labs YuE2
Wersja v1.0.0. Zobacz historię wersji.
Twórz piosenki lokalnie na podstawie tekstu i opisu muzycznego. Jeden kontener Docker udostępnia studio w przeglądarce, API HTTP, MCP i dźwięk stereo 48 kHz. Projekt korzysta z yue2.cpp, C++20 i GGML.
Szybki start
Potrzebujesz Dockera z obsługą GPU NVIDIA i sterownika zgodnego z CUDA 12.9.1.
Testowana karta to RTX 5070 Ti z 16 GB VRAM; innych konfiguracji nie zweryfikowano.
Jednorazowo pobierz dwa pliki modeli do data/models/.
Z katalogu zawierającego data/ uruchom jedną komendę:
Bash:
docker run -d --name yue2 --restart unless-stopped --gpus all -p 127.0.0.1:8087:8087 --mount "type=bind,source=$(pwd)/data/models,target=/models,readonly" --mount type=volume,source=yue2-output,target=/output hangrylabs/yue2:v1.0.0@sha256:446bd69099513f8b1d762656d455826872b7221ab232aa05e907f3ada90c9b34
PowerShell:
docker run -d --name yue2 --restart unless-stopped --gpus all -p 127.0.0.1:8087:8087 --mount "type=bind,source=$($PWD.Path)\data\models,target=/models,readonly" --mount type=volume,source=yue2-output,target=/output hangrylabs/yue2:v1.0.0@sha256:446bd69099513f8b1d762656d455826872b7221ab232aa05e907f3ada90c9b34
Otwórz http://localhost:8087, wpisz tekst i opis muzyki,
a następnie wybierz Generuj piosenkę. Python ani kompilator na hoście nie są potrzebne.
Komendy przypinają stabilną wersję v1.0.0. latest nadal śledzi rozwój.
Ten sam stabilny obraz jest dostępny jako
ghcr.io/hangry-labs/yue2:v1.0.0@sha256:446bd69099513f8b1d762656d455826872b7221ab232aa05e907f3ada90c9b34.
Pierwsze uruchomienie: pobieranie modeli
Utwórz data/models/ i zachowaj oryginalne nazwy plików. Łącznie to około 4,34 GB.
| Model | Zastosowanie | Rozmiar |
|---|---|---|
| YuE2-3B-Q8_0.gguf | Generowanie piosenek | 3,81 GB |
| YuE2-Vae-F32.gguf | Kodowanie i dekodowanie audio | 530 MB |
Manifest modeli zawiera sumy SHA-256. W kopii repozytorium
task models pobiera i sprawdza pliki. Wagi pozostają poza obrazem; serwer ich
nie pobiera. Po pobraniu obrazu i modeli generowanie działa bez internetu.
Warunki modeli są odrębne od licencji aplikacji.
Dostępne funkcje
- Piosenki z tekstu i stylu: pełna partytura, sama melodia lub tryb bez partytury.
- Stereo 48 kHz w Opus, MP3, Ogg, FLAC, WAV i AAC/M4A.
- Biblioteka przeglądarkowa: wyszukiwanie, ulubione, odtwarzanie i przywracanie opisów.
- Edytowalna partytura ABC, odtwarzanie z kodów semantycznych i kontynuacja źródła.
- Od jednego do trzech wariantów brzmienia tej samej kompozycji; domyślnie dwa.
- Lokalne adaptery LoRA oraz kodowanie/dekodowanie VAE dźwięku i latentów.
- Zadania asynchroniczne, anulowanie, limity kolejki i wyniki na trwałym woluminie.
- Stan modeli, kolejka, magazyn wyników i wykresy GPU NVIDIA w Systemie.
- Natywne API HTTP, zgodność z klientami OpenAI i narzędzia MCP dla agentów.
Transkrypcja i tokenizacja audio wymagają opcjonalnych modeli i argumentów serwera. Nie należą do domyślnego pobierania. Zobacz przewodnik po modelach.
Studio w przeglądarce
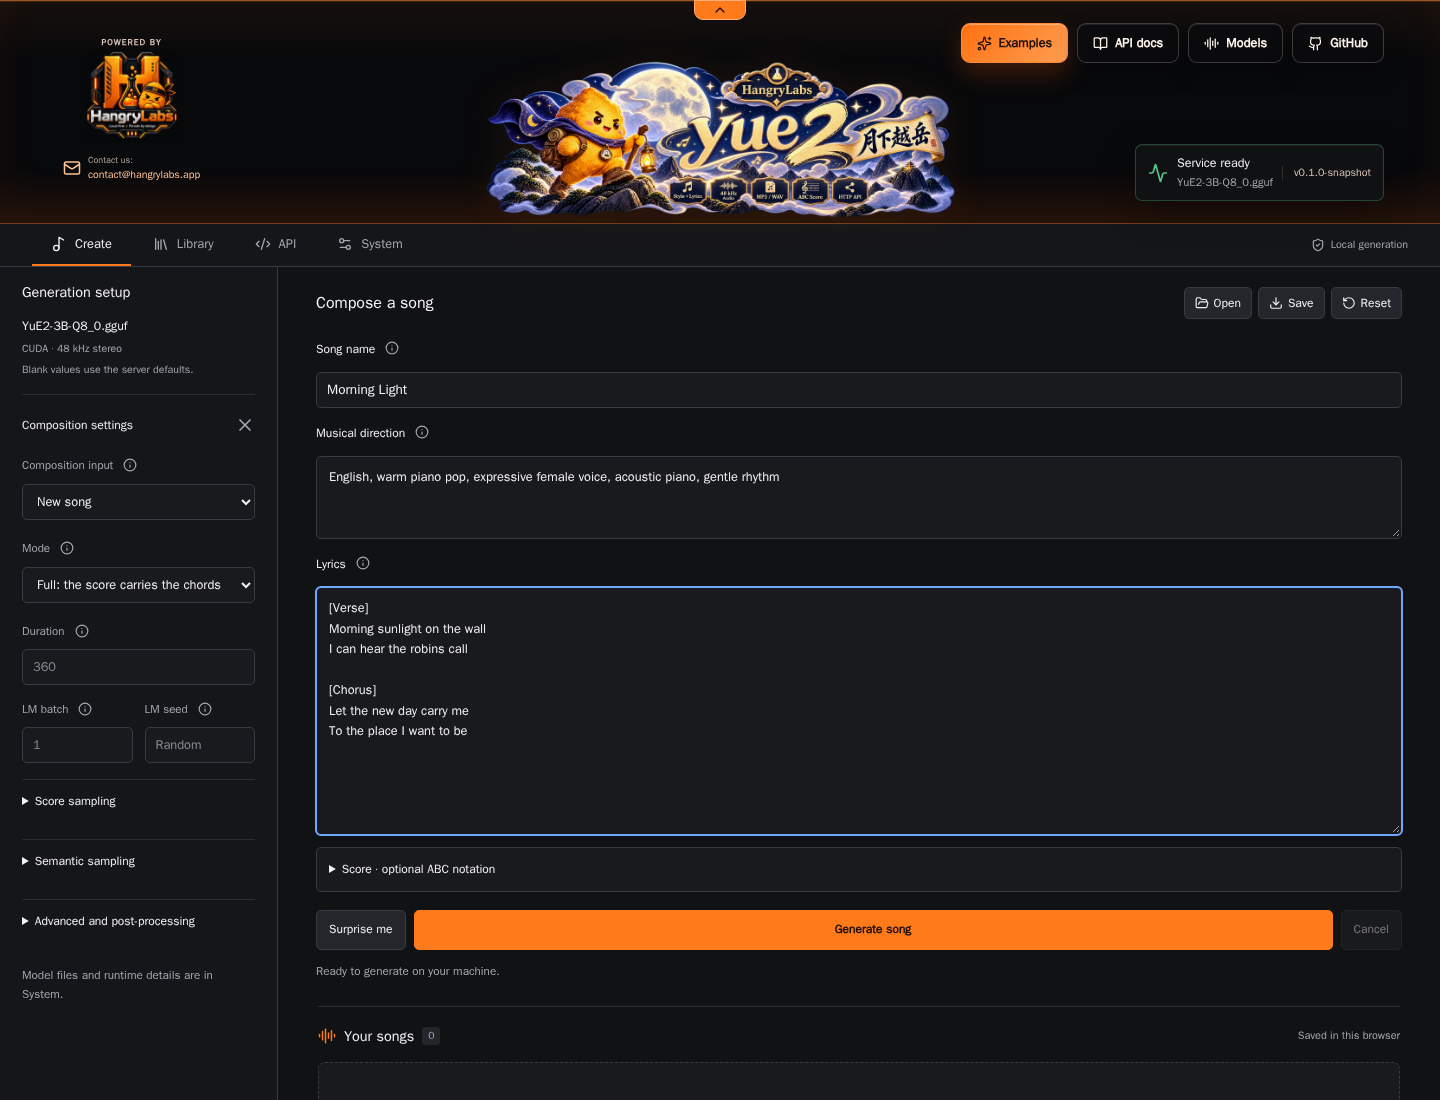
W nagłówku wybierz angielski, norweski bokmål, polski, japoński, chiński
uproszczony lub hiszpański. Przeglądarka zapamiętuje wybór. Bezpośrednie trasy to
/en, /nb, /pl, /ja, /zh i /es. Zmiana nie usuwa tekstu, ustawień ani
aktywnego zadania. Język interfejsu nie wybiera języka śpiewu ani nie tłumaczy tekstu.
Nowa piosenka za każdym razem komponuje na podstawie bieżących słów i opisu.
Użyj partytury ABC zachowuje wskazaną melodię. Odtworzenie kodów renderuje
istniejące wykonanie; zmiana słów nie przepisuje śpiewu zawartego już w kodach.
Gatunek, instrumenty, nastrój i głos opisuj osobno, a w tekście używaj oznaczeń
takich jak [Verse] i [Chorus]. To wskazówki dla modelu, a nie twarde gwarancje.
API i agenci
/v1/audio/music zwraca gotowy plik. /v1/audio/speech obsługuje klientów OpenAI,
ale także generuje muzykę, nie zwykłą mowę. /v1/models udostępnia informacje o modelu.
curl --fail-with-body http://localhost:8087/v1/audio/music -H 'Content-Type: application/json' --data '{"model":"yue2","lyrics":"[Verse]\nMorning light across the floor","style":"English acoustic pop, warm singing","duration":30,"steps":8,"response_format":"opus"}' --output song.opus
Natywne /synth zwraca identyfikator zadania. Sprawdzaj /job?id=JOB_ID aż do
done, potem pobierz /job?id=JOB_ID&result=1: multipart z dźwiękiem, JSON do
odtworzenia i latentami. Zobacz API, lokalną dokumentację
i schemat OpenAPI, dostępne także offline.
Klienta MCP połącz przez Streamable HTTP z http://localhost:8087/mcp.
Narzędzia: skill, generate_song, get_song, cancel_song. Agent najpierw
czyta instrukcję, pisze lub przygotowuje pełną piosenkę, a następnie dostaje
odnośnik HTTP ważny przez godzinę. Nie może zmieniać zaawansowanych ustawień środowiska.
Szczegóły: MCP.
Ustawienia i przechowywanie
Domyślnie: 8 kroków, losowe ziarna, kontekst 24 576 tokenów i dwa warianty. API muzyki/mowy oraz MCP zwracają jeden wariant na wywołanie. Czas jest górnym limitem; utwór może skończyć się wcześniej. Standardowo wagi są zwalniane między etapami. Wspierana dystrybucja GPU używa wyłącznie CUDA.
Wspólna kolejka ma jednego pracownika i osiem miejsc łącznie z aktywnym zadaniem.
Pełna kolejka odpowiada HTTP 429 z Retry-After; poczekaj przed ponowieniem.
/health, /status i /system/queue pokazują stan. YUE2_API_KEY chroni /v1
i /mcp, gdy jest ustawione; Studio i natywne trasy zachowują lokalny dostęp.
Domyślna komenda udostępnia port tylko na localhost.
Modele znajdują się na hoście. Wolumin yue2-output zachowuje gotowe wyniki po
wymianie kontenera. Natywne wyniki trwają domyślnie 24 godziny, linki agentów
godzinę. Biblioteka IndexedDB jest niezależna. Pobieraj ważne piosenki; folder
modeli nie stanowi kopii biblioteki przeglądarki. Zobacz kolejkę i magazyn.
Dokumentacja i rozwój
Spis dokumentacji · Docker · formaty audio · rozwój · zależności budowania · benchmarki. Szczegółowe referencje są po angielsku; strona wyraźnie oznacza brak tłumaczenia.
Z kopią repozytorium, Dockerem, Pythonem i Task: task models, task build,
task start. task validate sprawdza narzędzia, UI i kod natywny na CPU.
task test1 uruchamia stały test GPU. Podgląd strony: task pages; zatrzymanie:
task pages-stop. Benchmarki rozdzielają zimny start, ciepłe generowanie i VRAM.
ASR jest niedoskonałą wskazówką trendu, nie oceną jakości śpiewu.
Prywatność, autorzy i licencje
Generowanie odbywa się na Twoim komputerze. Pobieranie kontaktuje się z rejestrami i hostem modeli; UI nie wymaga CDN. Przetwarzaj materiały, do których masz prawa, i odpowiedzialnie udostępniaj wyniki. Integracje z zewnętrznymi produktami są osobnym zakresem.
MAP dostarcza modele, a yue2.cpp silnik natywny. Hangry Labs utrzymuje UI, API, kontenery i walidację. Kod projektu jest na licencji MIT; modele mają osobne warunki niekomercyjne. Zobacz źródła modeli i informacje o zależnościach. Kontakt: contact@hangrylabs.app.
Historia wersji
v1.0.0
Pierwsza stabilna wersja: lokalne studio, natywne i zgodne z OpenAI API, MCP, wielojęzyczny interfejs, zewnętrzne wagi i zweryfikowane zależności CUDA. Opublikowana 3 listopada 2026. Zobacz opis wydania. Szybki start przypina stabilną wersję i zweryfikowany skrót OCI.